
信頼する前に確かめる
ページごとに、テキストだけでなく品質シグナルが付きます。警告は文字化け、画像化されたテキスト、読み順の乖離といったリスクを名指しし、次に取るべき手段で締めくくります。
PDF 抽出のいちばん厄介な性質は、失敗が成功のように見えることです。スキャンは空のテキストを返し、壊れたフォントマップは一見読めそうなゴミを返し、2 段組みの論文は段が入り混じって返ってきます。そのどれもが、正常に成功した結果として返ってきます。それを信じたエージェントは、何かがおかしいと気づかないまま誤った答えを出します。
この領域の多くのツールが目指しているのは変換です。PDF をきれいな Markdown に変え、その結果が忠実であることを願います。pdfvision が目指すのは診断です。抽出を信頼できないページに印を付け、その箇所に絞った視覚的な根拠を取りにいきます。
pdfvision が前提にしているループはこうです。
これは人間が PDF を読む流れに近いものです。ページをざっと見て、視覚的なページと抽出テキストが食い違う場所に気づき、答えの決め手となるグラフやフォーム欄を拡大する、という流れです。
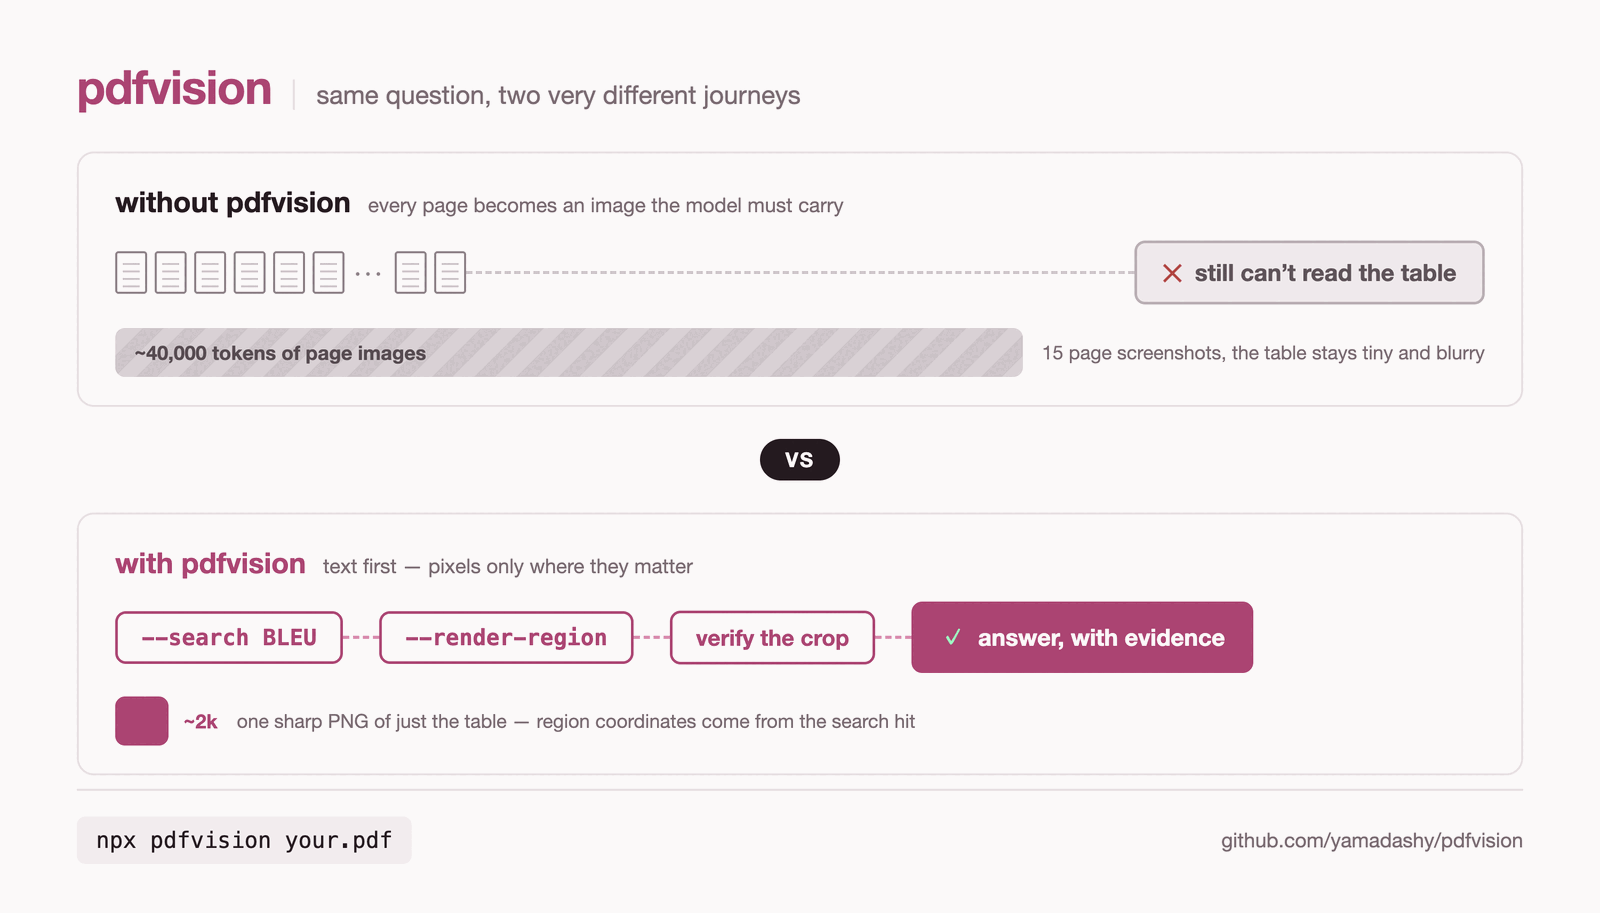
レイアウト復元、OCR、visual region など残りの機能は ガイド で扱います。
インストールせずに実行します。
npx pdfvision document.pdf抽出がうまくいかないときは、ページ自身がそう伝えます。次の例で警告が指摘しているのは見た目の順序とネイティブテキストの順序の乖離ですが、警告が引用している行はもうひとつの問題も明らかにします。この PDF のフォントマップでは、図のラベル列が文字化けするのです。
$ npx pdfvision tracemonkey.pdf -p 10
_chars: 6944 · images: 0 · coverage: 42% · vectors: 17 · warnings: 1 · size: 612×792pt_
… page body …
### Warnings
> **warning** (reading_order_divergence): layout line "?>9@AJ.0A:</C./8-2#3$4%56#" appears
> after "?>9@AJ.D<F@-<>2.@A:0>#3$4,56#" visually but earlier in the native text stream —
> native line order diverges from what a human reads; the body above is that reading order,
> rebuilt from the layout — render the page when exact sequence is critical
この警告がなければ、エージェントは ?>9@AJ.0A:</C./8-2#3$4%56# を抽出成功として読み、そのまま気づかずに終わります。
マルチモーダルモデル向けにページ画像をレンダリングします。
npx pdfvision document.pdf --renderURL から PDF を取得して JSON で抽出します。
npx pdfvision --remote https://raw.githubusercontent.com/mozilla/pdf.js-sample-files/master/tracemonkey.pdf --format json根拠を検索し、一致領域だけをクロップします。
npx pdfvision report.pdf --search "revenue" --json
npx pdfvision report.pdf --pages 3 --render --render-region 120,180,360,140 --render-output ./crops --json
全ページをレンダリングせずに視覚構造を調べます。
npx pdfvision slides.pdf --layout --image-boxes --vector-boxes --visual-regions --json
npx pdfvision slides.pdf --render-visual-regions --render-output ./regions --json